Состав системы
Пользователи корпоративных сервисов
Утром сотрудники обнаружили, что сетевые папки и внутренняя программа недоступны. Первой задачей было не модернизировать инфраструктуру, а вернуть доступ к рабочим данным.
Пользователи корпоративных сервисов
Аварийное восстановление → модернизация → сопровождение
Отказ физического сервера, часть операций остановлена
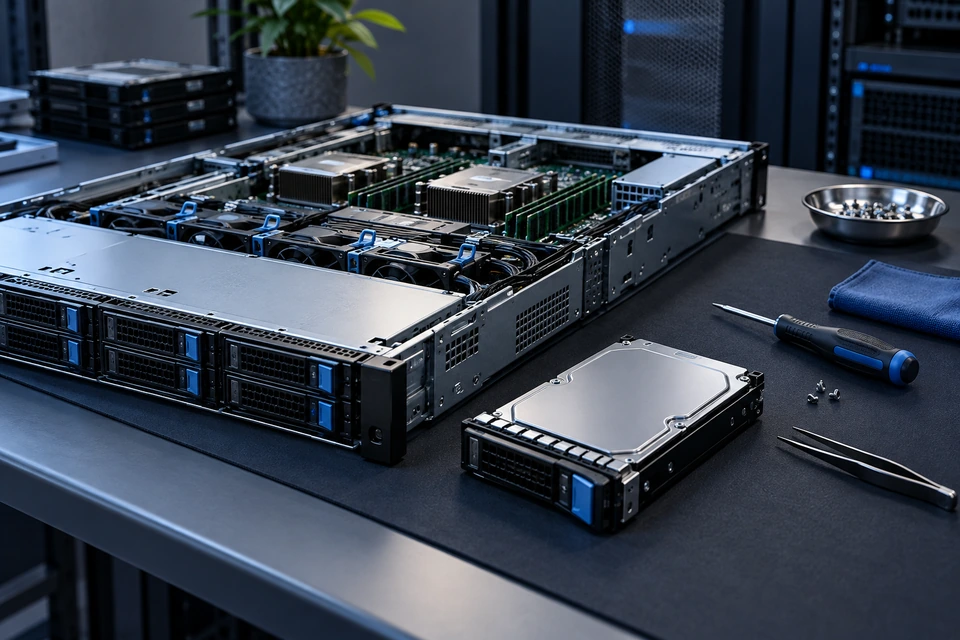
Физический сервер включался, но операционная система работала нестабильно. Компания фактически остановила часть операций.
Было проверено состояние дисков и доступность последних резервных копий. Критичные данные удалось восстановить на временную систему. Это позволило вернуть ключевые процессы, пока велась диагностика основного оборудования.
Инцидент оказался следствием не одной ошибки: сервер был старым; мониторинг отсутствовал; предупреждения накопителей никто не отслеживал; backup существовал, но контроль его состояния не был частью регулярного обслуживания.
Таким образом, сам отказ оборудования был только финальной стадией проблемы.
После восстановления текущей работы была построена новая схема. Сервисы перенесли на виртуальную платформу. Резервное копирование вынесли на отдельное устройство. Критичные компоненты подключили к мониторингу. Для оборудования определили график профилактической проверки.
Невозможно гарантировать, что оборудование никогда не выйдет из строя. Поэтому задача инфраструктуры другая: сбой не должен превращаться в неизвестную ситуацию. Должно быть заранее понятно:
Именно это компания получила после проекта: известный состав инфраструктуры, отдельное резервирование, наблюдаемые критичные компоненты и порядок действий при отказе.
PROXMOX WINDOWS SERVER / LINUX BACKUP NAS SMART-МОНИТОРИНГ ZABBIX MIKROTIK
Подробности о технологиях из этого кейса: резервное копирование и восстановление и мониторинг инфраструктуры. С чего начать наблюдение за инфраструктурой — в статье «Zabbix: что мониторить в первую очередь» нашей Базы знаний.
При восстановлении сначала определили границы отказа и состояние носителей. До действий, меняющих данные, сохранили доступные исходные материалы. Проверили резервные копии и зависимости: идентификация, DNS, хранилище, база и прикладной сервис.
Сервисы возвращали по приоритету. Восстановленные данные проверяли в отдельном окружении, а пользователям открывали доступ после проверки приложений. Временные решения зафиксировали отдельно, чтобы они не превратились в незаметную постоянную конфигурацию.
После запуска проверили пользовательские операции и очередное резервное задание. В разборе инцидента отделили подтверждённую причину от предположений, составили перечень мер и порядок действий при повторении сбоя.
Доступ к приложениям и данным нарушен.
Нужно установить границы отказа и пригодность копий.
Изменяющие данные действия отделены от первичного обследования.
Сервисы возвращаются по согласованному приоритету.
Проверяются рабочие операции, копии и повторные ошибки.
Сохранение исходного состояния → проверка источника восстановления → зависимости → приложение → проверка пользователей.
Восстановление работы и установление причины — разные этапы. В разборе инцидента подтверждённые факты отделяются от гипотез.
Структура документа помогает связать конфигурацию с её назначением и порядком обслуживания. В рабочую версию вносятся параметры системы и согласованные ответственные.
Скачать лист проверки · MarkdownРоли и обозначения условные: фрагмент раскрывает логику решения, не содержит адресов и доступов заказчика.
Скачать технический фрагмент · Markdown
| Раздел | Фрагмент записи | Что подтвердить |
|---|---|---|
| Сохранение состояния | Не перезаписывать единственный носитель; сохранить журналы | Отдельная рабочая копия для диагностики |
| Очередь | Сеть и имена → данные → приложения → рабочие места | Проверка зависимости перед следующим этапом |
| Закрытие | Сверка данных, доступов и задания копирования | Результат операции и список оставшихся ограничений |
Для каждой проверки нужны действие, ожидаемый результат и запись фактического наблюдения. Ниже — критерии для такой задачи; значения и замечания фиксируются при выполнении работ.
| Что проверять | Как проверить | Критерий результата |
|---|---|---|
| Границы отказа | Проверка сети, хранения и зависимых сервисов | Определены затронутые компоненты и приоритеты возврата |
| Работа после восстановления | Вход пользователей и согласованные операции с данными | Сервисы доступны; состав и актуальность данных проверены |
| Дальнейший контроль | Проверка следующего резервного задания и событий мониторинга | Контроль не прерывается после разового запуска приложения |
Дата, исполнитель, проверяемый экземпляр, фактический результат и отклонения. Если критерий не выполнен — замечание, следующее действие и решение о переключении или возврате.
Расскажите, что нужно восстановить, модернизировать или взять на сопровождение. Предложим подходящий вариант реализации.